Posts

Artificial Neural Network - 經歷著人工智能寒冬和復興

Image
ANN, Artificial Neural Network是模仿生物神經網路數學模型,也作為深度學習和人工智能十分重要的基礎,所以筆者會花很多的筆墨解釋其設計,運作,後來的演變過程,盡量用簡單易明的例子作闡釋。 在了解整個神經網絡(Neural Network)之前,我們先從一個獨立的神經元開始說起吧, 幻想每一個神經元是一個只懂吃喝玩樂的他媽哥池(台灣的朋友們會叫它塔麻可吉),在他的世界裡只有吃喝和玩樂,至於決定先吃還是先玩,那就要看看他先收到肚子餓的信號還是享樂的心癮;換個角度來說,一個較為貪玩的他媽哥池會容易心癮發作,較饞嘴刖對肚子餓特別敏感,他媽哥池會收集所有資訊,根據它自己對吃或玩的敏感度,並把它們轉化為相應的決定或行動。 信號就是進入神經元的Input,敏感度就是權重Weight,對某信號的敏感度愈高,Weight也會愈提高,每一個Input都會有屬於它自己的Weight,然後神經元把一連串的Input乘上對應的Weight,並加起來放進Activate Function來決定Output的值是什麼,也就是要作出什麼的決定。 $$y=f(w_0x_0+w_1x_1+...+w_nx_n)$$ 當一個又一個的他媽哥池連接起來成為Artificial Neural Network,以一個完整的Network來說,結構以一層層的Layer造成,第一層被稱為Input Layer,最後的層為Output Layer,剩下的夾心階層就是Hidden Layer。 心水清的讀者們認該會意識到,如果沒有hidden layer的Network,activation function為Sigmoid Function的話,那麼它正正是最基礎的Logistics Regression,bias就等同於Intercept,把Input乘上對應的Weight再直接加起來,經Activation function 再決定Output是什麼。 當我們解釋哪一個Input (Factor)最影響預測結果,只要用上Wald Test就好了。但是當加上一層Hidden Layer,就不再簡單了。所以層數越多的網絡,預測結果便難以解釋,越來越像一個”黑盒”。再者,Hidden Layer裡的神經元的數量是決定參數Weight的數量,在筆者多篇文章也提...

書中自有黃金屋?從Sparktake.com的文章找Keywords

Image
筆者最近想玩NLP和Text Mining,於是拿了朋友經營的網站Sparktake.com做了些小嘗試,Sparktake除了開發了熱門的手機程式:二手書買賣平台,也定期發佈不少令人發人深省的讀後感和心得。而筆者看看能不能在眾多的文章中準確和自動地抓住每一篇的重點字眼。 正所謂凡事起頭難,當手頭上沒有任何Data的時候,就唯有自己打開Sparktake.com動手Scrape吧。 經歷一番的折騰,終於把一共116篇的文章,包括標題 ,內容,發佈時間,Tag一併地拿下,把其放進一個csv檔裡作之後的分析。基於Sparktake的文章絕大部分是用中文所寫的,擷取的內容都encode成為utf-8再存起來,免得亂碼等問題暗中作怪。 Sparktake.com 接下來是Preprocessing的環節,就先把英文字母和一些Special Character (例如:”\n”, \r”等)都刪去,只留下中文字的UTF-8,再decode轉換成Unicode。同時,筆者用上大家都不會陌生的Jieba(結巴),這個Python Package來做中文的NLP。在找出關鍵字前,我們先從所有文章作一個整體的分析。Jieba的tokenizer可以把整篇內容的每一句句子都切成一組又一組的詞語,即是: "一個人遇上一本書,都是緣份使然。看了多少本書並不重要,重要的是我從中有多少得益。" 切成:  "一個", "人", "遇上", "一本", "書", ",", "都", "是", "緣份", "使然", "。", "看", "了", "多少", "本書", "並", "不", "重要", ",", "重要", "的", "是", "我", "從", "中...

KNN - 近朱者赤 近墨者黑

Image
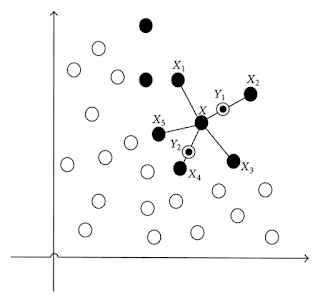
初接觸Machine Learning的朋友們,對KNN這個算法應該也不陌生了,原理既容易理解,應用也十分廣泛,只要有足夠的鄰居(訓練數據),也可以用作分類或迴歸(Regression)的方面工作。舉一個活活的例子,中學時代(當時還沒有Online social platform ,感嘆時代的變遷 )總會遇上一個暗戀對象,但對他/她的背景認識還未夠深,便會傾向留意和觀察他/她身邊的朋友是那種人,從而判斷他/她是一個怎麼樣的人。正所謂近朱者赤,近墨者黑,而是近硃砂的會被判定為染成紅色,靠近墨的則是黑色,也同時寓意Testing Data的預測結果因環境(Training Data)所影響的。 KNN屬於機器學習中的Supervised learning其中一種算法,從訓練數據的Label進行學習,建構好的模型要,首先要知道KNN全名為K-nearest neighbors,即利用k個最近似的鄰居,最後"以多數服從少數"的方式判斷該人/事是屬於那種類別。為了讓讀者明白整個算法的原理,有9個數據點,其中8個來自Training Data,分別有4個藍色的,4個紅色的;至於中間有一紅點,它是來自Testing Data的,最一開始我們是不知道它是紅還是藍的,假設我們用3位鄰居(k = 3)便決定是什麽,會發現其中兩個是紅的,另外一個是藍的,根據"多數服從少數",這個被判斷為紅色,最後也因此我把它變成紅色了。 把以上的原理拓展到更多的數據量,更多的Features,更多的類別(Class),便能應用在各式各樣的Business / Research Problem。不過要深入理解這個Algorithm的設計,了解到這個程度是還不足夠的,我們還需要明白以下的學問包括: 誰是鄰居們? 要多少個鄰居(k)才夠呢? 誰是鄰居們? 要判斷那些是鄰居的話,首先要量化相似度,而Eulidean Distance是比較常用的方法來量度相似度: $Distance = \sqrt{\sum_{i=1}^{k} (x_{i}-x_{self})^2}$ (注:Eulidean Distance只是其中一個量化距離的方法,其他的例如Manhattan Distance,在High Dimension高維度甚至會發揮得更好,所以...

Clustering - 物以類聚

Image
經過一學期的折磨,筆者終於挨過去了,直到現在才有空寫文。今次的主題是一個非常入門也是很重要的,那就是Clustering! Clustering (聚集) 一般用作把相似的事物,都把它圈起來,至於多少個群組才是最好,留在之後討論吧。在香港有一句押韻冷笑話:痴痴呆呆;坐埋一枱。愈痴呆愈容易會被圈起來。在介紹當中的算法設計,我們先反思為什麼Clustering的出現是那麼重要呢? 首先,Clustering這個算法是非監督式的(Unsupervised),這意味著它不會透過已知的答案去訓練自己,反過來是根據數據本身的特質去計算相似度,然後把集群圈出來。舉例來說,對於我們人腦要分辦男女是一件如意反掌的事,但對機器並不是,Clustering在訓練過程不會因為知道男女,只會把相似的特質的人圈起來,當然,我們要教會機器利用適合的特質,例如:身高,頭髮長度等特徵,來進行聚集,否則永遠結果都不似預期的。來到這裡,有讀者可能會反思一下,竟然我們都已經能輕易分辦男女,早已知道答案是什麼,為何不直接不用監督式的算法呢?因此,認請楚自己的想達到的目標和了解算法背後的設計的原意,無論在數據分析或者機器學習均是極為重要的第一步!來總結一下,Clustering可在人們心中沒有答案的前提下,圈出群組來作分類。另外, 請記僅用作分類的算法,不一定是監督式的 。 在數學上,一般會用距離來量化相似度,這是最直觀和容易解稱的。而距離的計算方法,也有很多不同樣式,而最常用的是Euclidean Distance:$\sqrt{\sum_{i=1}^n (x_i - y_i)^2}$,假設$x$和$y$這兩點都依付在一個笛卡爾坐標平面上,即是$n=2$,用以前中學學習的距離分式就是:$\sqrt{\sum_{i=1}^2 (x_i - y_i)^2}$,你會發現兩點之間的最短離正正是Euclidean Distance。假設痴呆程度是由兩個特徵:行為和心理(5分為滿分 ,代表最痴呆)這兩個因素組成的,現在有一對痴呆和正常的朋友,他們的距離等於$\sqrt{(5-0)^2+(5-0)^2}=5$,如果兩個都是痴呆的話,距離就變短了:$\sqrt{(5-5)^2+(5-5)^2}=0$。所以距離愈少的,暗示了兩者相似度十分的高。 當明白了距離的藝術之後,要理解Clustering這算法的設...

機器學習之陷阱 - Imbalance Class Classification

Image
幾年前的筆者,一直覺得Build Model是一件很不可思議的事,一提到建模這個課題,就會眼前一亮,充滿好奇和期待,不知道讀者們有沒有嘗試過在做分類(Classification)的時候,一看到數據,也沒有想太多,直接就把數據倒進模型作訓練,再看看Performance有多少,看到準確度有92%,表現很不錯吧,我看的是不一定了,為了讓讀者們更好理解文中的意思,我會採用"十個男人九個滾"的例子來闡釋。 假設我收集了100個男人的資料,9成2的人都曾經對伴侶不忠,其餘的就管它是還在考慮或是打死不會,目的是從這些會出軌和不會的男人身上,讓我的Model學習出軌的男人特點,從而預測其他男人會否對伴侶不忠,剛才說過我的模型有92%的準成度,筆者還以為可以慶功食牛雜,女人們以為可以試試伴侶是否不忠的時候,才發現所有的男人都被預測為"出軌",當中包括真的會出軌的92人, 其餘8個白白被"砌了生豬肉",還未出去滾已慘遭被判為出軌,要是這樣,倒不如直接說成"十個男人十個滾",連Build Model的氣力也省去了,所以零分重作吧! Actual / Predict           滾             沒滾 / 唸緊   滾 92 0 沒滾 / 唸緊 8 0 但是為何會發生這種事呢?明明準確度很高,結果卻不似預期。其實原因很簡單,這都是數據的類別分佈出現不均勻和分類器(Classifier)的設計所造成的,因為一般的Classifier的學習目標是優化準成度,透過獲得愈少的誤差,才不會考慮類別的分佈,也就是少數的聲音很容易被埋沒,導致Classifier難以從少數類別的Pattern中學習,最壞的結果就是剛才的結果:所有數據都分成同一類別。 雖然Imbalance Class不是一個新鮮的問題,但對於入門級的人,想要對模型或數據分析技巧更上一層樓的話,這些基礎是少不了,如果沒有這些理論在背後支持,我相信街上每一個的Programmer也會比你強,只要寫幾句Coding,便能輕鬆實現建模,測試和預測,那麼你就好好想一下作為數據分析師的價值何在。...

Qilkview - 細有細玩、大有大玩

Image
不知道讀者們會不會跟筆者一樣喜歡把很多的資訊,都集中在一個介面裡,一目了然地查看自己有興趣的資訊,讓自己看起來很專業和高科技的。有人會叫它作BI Tools,或者Interactive report,而最多人會稱它作Dashboard。 說到Dashboard要用什麼的工具來開發,在坊間有很多的選擇和方法,一個最簡單的方法就是利用Excel預先設計好的圖表,加上某些重要的KPI,一個靜態的Dashboard就完成了,不過Excel最新版本的Excel 2016推出之後多了PowerPivot這個新功能,讓你的圖表更互動和更Readable。 最複雜的玩法,就是把充滿圖表數字結果的Dashboard放在網上供所有人瀏覽,無論後台或前台都要準備不少功夫,前台需要設計網頁,把圖表安置至在其中,而後台則要準備伺服器來Host這個網頁。 不過以經濟效益的角度,找一個性價比最好的工具來開發一個Dashboard,上述的都不是最好。所以我今次要介紹的是Qlikview這個強大和更有彈性的Application,對於新手來說它是一個惡夢,因為它的功能和設定多不勝數,但對高手來說簡直是恩物,本身複雜的圖表,加上一些Coding的幫助,會讓你的Dashboard達到很佳的interactive的效果,更上一層樓。 大概幾年前,筆者在找工作的時候,發現有做BI (Business Intelligence)的公司都在找Qlikview的開發者,雖然不知道Qlikview現在在香港的人力市場裡面還有多少含金量,但至少這個Application在Data Science的世界也是值得一提的。 那麼一起來感受下Qlikview強大的地方吧。由於筆者太過無聊的關係,無意中發現Data.Gov.HK,資料一線通的官網設計進行大翻新過,或許是媒體,業界人士都不停批評政府在推行開放數據顯得緩慢,甚至根本不理解開放數據的真正意思,令它們終於醒覺到需要進行改善工程。無可否認,現在的數據庫是比以前的來得豐富,也多了不少機構提供它們自家的數據。當我看到網頁的右上角顯示了"歷史的數據",我還十分期待有Time Series既數據可以玩一下,卻發現那些根本不是"歷史"數據",是"最新"數據....... 我當堂嚇一跳,然後得...

Anaconda - 給見習分析師的就職禮物

Image
正所謂工欲善其事,必先利其器。要作好的分析,你一定要準備好和了解你的工具。 有一群Data Scientist開始意識到無論傳統或是新的工具實在太多和太複雜,也不想再局限於只有SpreadSheet的世界,讓更多並非Software Engineer, Programmer出身的人增值自己,從數據中發現和分析他們一直好奇的事物,甚至解決業務和工程上的問題,而又不必是一個Software Experts或者Engineer,於是,這群人便創立了Anaconda Cloud。 為何筆者會介紹他們,不是因為收了稿費,而是這個團隊出產的Anaconda,是一個由Python支援的Open Data Science Platform,這個平台正正讓筆者受惠不少,筆者在早一兩年前,舊公司電腦的操作系統是Window,在安裝或導入一些Package遇到不少的問題,到現在服務的公司對軟件安裝亦有所限制,安裝Package的時候,也要做了不少手腳才可完成。最近得知這個Anaconda,讓我在幾分鐘內,便準備好我所需的工具,還記得筆者當年要花幾天的時間來弄好那些煩人的設定。相信有用過Python的讀者們都會經歷過這些痛苦,不過現在現在進場的人,因為Anaconda已為我們準備好上戰場用的武器。 想下載的朋友們,在他們的官方網站( https://www.continuum.io/downloads )根據你的Operating System,選擇合適的安裝檔來安裝Anaconda吧!我會建議各位安裝Python 3.6,因為Python 2.7快沒有Support了。途中它會問你想為個人還是所有用戶安裝,只要選"Just Me"就可以了。 完成後,你會看到很多很熟識的工具,也可能你看到的只是陌生的Logo,不要緊,我會介紹常用而實用給各位們。想安裝Package的朋友,不用擔心,因為它已經內置了所有常用的Package: NumPy , SciPy, Pandas , Scikit-Learn , NLTK, R-essentials等等,連筆者最近用來Build Dashboard的Flask也有,所以它真是初心者的恩物,為你提供整合了的資源,直接投入生產。 首先,Anaconda Cloud是一個官網的Shortcut,有...