Posts

Showing posts with the label datamining_ch

Boosting vs Bagging? 別再胡亂用了!

Image
許多初接觸數據科學的朋友心裡都有一個疑問:什麼時候應該使用 XGBoost 或隨機森林這樣的模型?有些朋友也可能被面試官考問如何區分Boosting跟Bagging這種問題。無論您是否有這痛苦的 經歷 ,懂得區分兩者的分別也是十分 重要的,尤其在 我們選擇那一個預測模型 。 在了解 Boosting跟Bagging 之前,首先需要瞭解Bias和Varaince的概念。 如果讀者們沒有聽說過,筆者 建議您在我的舊文先了 解一下 。 首先,Boosting跟Bagging都屬於Ensemble Method,原理將數個基礎模型(Base Model) 放在一起,給出更準確的結果,展示出 團結就是力量 。以Random Forest Classifier ( 隨機森林分類器) 為例,它的基本模型應該是(Decision Tree Classifier)決策樹分類器,我們也稱之為 " 弱分類器 (Weak Classifier) " 。在大多的情況下,Boosting或者Bagging模型表現都勝於單個模型,不過我們還是需要知道哪時候使用 ,才不會白費功夫 。 Bagging 我們先談 談 袋裝, 因為它比Boosting原理更直觀和容易理解。Bagging全名為 Bootstrapping Aggregatingm,當中的 Bootstrap 是根據 N 個 Data Point,用隨機抽樣的方式,從N個抽出K個 Data Point,並 建立一組又一組的樣本,然後 Weak Learner 可以從建立好的樣本中進行學習。 隨機森林就 是一個典型 Bagging的例子 。而決策樹扮演著Weak Learner的角色。如果您對決策樹沒有任何瞭解,下面是建議的閱讀( TODO : URL )。 訓練數據會被 隨機抽樣,抽出部分的紀錄和部分的特徵,建立一組組的樣本,而 每棵樹便會學習對的樣本,這些獨立學習好的樹,都會產出一個預測結果,取 平均值,便是一個綜合的 預測結果 。現在,你可能知道為什麼它會被稱之為 " 隨機 " 和 " 森林 " 。實際上,其原理是使每一個基礎模型學習方法都是相互獨立,以儘可能減少 Variance,但同時也犧牲Bias。簡單地說,Bagging主要用作來解決Overfitting...

Bias vs Variance - 世上是沒有完美的Model

Image
相信讀者們在看我寫的文章經常提到Overfit, Regularization等對普通人頗為陌生的字眼,未必能一時理解其意思,甚至覺得一頭霧水。所以我會在這篇文章集中逐一詳解其意思,這些字眼都是描述在建立Supervised Learning的模型時所遇上的問題,和應該作出什麼的取捨或修正。文中免不了數式來解釋,如果看不懂的,可以直接忽略的,筆者會加上淺白的文字和圖像解釋。 這一切都是取捨 香港寸金尺土,那麼用作樓價作為例子,假設我們不知道新樓盤的價錢,但至少我們知道樓盤的實用面積($x$),利用這個資料來估計該物業的價錢($y)$,當然我們可以build一些model,用的可以是最簡單的Regression至更複雜的Neural Network,但當最後選出那個模型是最好的時候,應該要怎樣選擇呢?首先要先明白兩個重要的指標: Bias及Variance。它們均是用作量度誤差,因為學習的過程是Supervised的,我們本來事先已經知道真正答案,即是y-label,只要對比預測出來和真實答案便可得出Error,也就是: $$error = (真實答案 - 我們的模型預測結果)^2=(y - \hat{f}(x))^2$$ 而我們建立出來的模型其實是approximate出來,只是近似不是真正的,因此在f(x)上加上hat:$\hat{f}(x)$以表示我們建立的模型。 兩邊加上Expectation後: $$E(error) = E(y - \hat{f}(x)))^2$$ 假設這個世界有真正的模型, $f(x)$,再加上一些White Noise, $\epsilon$ (平均值為0, Variance為\sigma, 常態分怖的隨機數字),便可以解答到真實的答案,即是$y = f(x) + \epsilon$。只要把剛才的公式作一一些手腳,經過大量的運算,最後變成得出另一條有著其他意思的公式: $$E(error) = (f(x) - E(\hat{f}(x))^2 + Var(\hat{f}(x)) + \sigma = Bias + Variance + Noise$$ Bias及Variance一同出現鳥!這裡顯而易見,預期的誤差其實是由三個部分造成,Bias的多少是由正確答案和我們的模型得出的答案有多不同,愈高的Bias代表...

Artificial Neural Network - 經歷著人工智能寒冬和復興

Image
ANN, Artificial Neural Network是模仿生物神經網路數學模型,也作為深度學習和人工智能十分重要的基礎,所以筆者會花很多的筆墨解釋其設計,運作,後來的演變過程,盡量用簡單易明的例子作闡釋。 在了解整個神經網絡(Neural Network)之前,我們先從一個獨立的神經元開始說起吧, 幻想每一個神經元是一個只懂吃喝玩樂的他媽哥池(台灣的朋友們會叫它塔麻可吉),在他的世界裡只有吃喝和玩樂,至於決定先吃還是先玩,那就要看看他先收到肚子餓的信號還是享樂的心癮;換個角度來說,一個較為貪玩的他媽哥池會容易心癮發作,較饞嘴刖對肚子餓特別敏感,他媽哥池會收集所有資訊,根據它自己對吃或玩的敏感度,並把它們轉化為相應的決定或行動。 信號就是進入神經元的Input,敏感度就是權重Weight,對某信號的敏感度愈高,Weight也會愈提高,每一個Input都會有屬於它自己的Weight,然後神經元把一連串的Input乘上對應的Weight,並加起來放進Activate Function來決定Output的值是什麼,也就是要作出什麼的決定。 $$y=f(w_0x_0+w_1x_1+...+w_nx_n)$$ 當一個又一個的他媽哥池連接起來成為Artificial Neural Network,以一個完整的Network來說,結構以一層層的Layer造成,第一層被稱為Input Layer,最後的層為Output Layer,剩下的夾心階層就是Hidden Layer。 心水清的讀者們認該會意識到,如果沒有hidden layer的Network,activation function為Sigmoid Function的話,那麼它正正是最基礎的Logistics Regression,bias就等同於Intercept,把Input乘上對應的Weight再直接加起來,經Activation function 再決定Output是什麼。 當我們解釋哪一個Input (Factor)最影響預測結果,只要用上Wald Test就好了。但是當加上一層Hidden Layer,就不再簡單了。所以層數越多的網絡,預測結果便難以解釋,越來越像一個”黑盒”。再者,Hidden Layer裡的神經元的數量是決定參數Weight的數量,在筆者多篇文章也提...

KNN - 近朱者赤 近墨者黑

Image
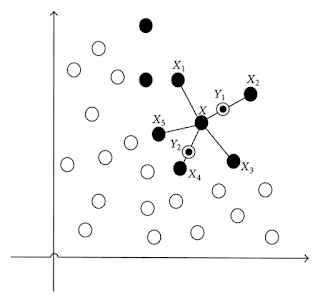
初接觸Machine Learning的朋友們,對KNN這個算法應該也不陌生了,原理既容易理解,應用也十分廣泛,只要有足夠的鄰居(訓練數據),也可以用作分類或迴歸(Regression)的方面工作。舉一個活活的例子,中學時代(當時還沒有Online social platform ,感嘆時代的變遷 )總會遇上一個暗戀對象,但對他/她的背景認識還未夠深,便會傾向留意和觀察他/她身邊的朋友是那種人,從而判斷他/她是一個怎麼樣的人。正所謂近朱者赤,近墨者黑,而是近硃砂的會被判定為染成紅色,靠近墨的則是黑色,也同時寓意Testing Data的預測結果因環境(Training Data)所影響的。 KNN屬於機器學習中的Supervised learning其中一種算法,從訓練數據的Label進行學習,建構好的模型要,首先要知道KNN全名為K-nearest neighbors,即利用k個最近似的鄰居,最後"以多數服從少數"的方式判斷該人/事是屬於那種類別。為了讓讀者明白整個算法的原理,有9個數據點,其中8個來自Training Data,分別有4個藍色的,4個紅色的;至於中間有一紅點,它是來自Testing Data的,最一開始我們是不知道它是紅還是藍的,假設我們用3位鄰居(k = 3)便決定是什麽,會發現其中兩個是紅的,另外一個是藍的,根據"多數服從少數",這個被判斷為紅色,最後也因此我把它變成紅色了。 把以上的原理拓展到更多的數據量,更多的Features,更多的類別(Class),便能應用在各式各樣的Business / Research Problem。不過要深入理解這個Algorithm的設計,了解到這個程度是還不足夠的,我們還需要明白以下的學問包括: 誰是鄰居們? 要多少個鄰居(k)才夠呢? 誰是鄰居們? 要判斷那些是鄰居的話,首先要量化相似度,而Eulidean Distance是比較常用的方法來量度相似度: $Distance = \sqrt{\sum_{i=1}^{k} (x_{i}-x_{self})^2}$ (注:Eulidean Distance只是其中一個量化距離的方法,其他的例如Manhattan Distance,在High Dimension高維度甚至會發揮得更好,所以...

Clustering - 物以類聚

Image
經過一學期的折磨,筆者終於挨過去了,直到現在才有空寫文。今次的主題是一個非常入門也是很重要的,那就是Clustering! Clustering (聚集) 一般用作把相似的事物,都把它圈起來,至於多少個群組才是最好,留在之後討論吧。在香港有一句押韻冷笑話:痴痴呆呆;坐埋一枱。愈痴呆愈容易會被圈起來。在介紹當中的算法設計,我們先反思為什麼Clustering的出現是那麼重要呢? 首先,Clustering這個算法是非監督式的(Unsupervised),這意味著它不會透過已知的答案去訓練自己,反過來是根據數據本身的特質去計算相似度,然後把集群圈出來。舉例來說,對於我們人腦要分辦男女是一件如意反掌的事,但對機器並不是,Clustering在訓練過程不會因為知道男女,只會把相似的特質的人圈起來,當然,我們要教會機器利用適合的特質,例如:身高,頭髮長度等特徵,來進行聚集,否則永遠結果都不似預期的。來到這裡,有讀者可能會反思一下,竟然我們都已經能輕易分辦男女,早已知道答案是什麼,為何不直接不用監督式的算法呢?因此,認請楚自己的想達到的目標和了解算法背後的設計的原意,無論在數據分析或者機器學習均是極為重要的第一步!來總結一下,Clustering可在人們心中沒有答案的前提下,圈出群組來作分類。另外, 請記僅用作分類的算法,不一定是監督式的 。 在數學上,一般會用距離來量化相似度,這是最直觀和容易解稱的。而距離的計算方法,也有很多不同樣式,而最常用的是Euclidean Distance:$\sqrt{\sum_{i=1}^n (x_i - y_i)^2}$,假設$x$和$y$這兩點都依付在一個笛卡爾坐標平面上,即是$n=2$,用以前中學學習的距離分式就是:$\sqrt{\sum_{i=1}^2 (x_i - y_i)^2}$,你會發現兩點之間的最短離正正是Euclidean Distance。假設痴呆程度是由兩個特徵:行為和心理(5分為滿分 ,代表最痴呆)這兩個因素組成的,現在有一對痴呆和正常的朋友,他們的距離等於$\sqrt{(5-0)^2+(5-0)^2}=5$,如果兩個都是痴呆的話,距離就變短了:$\sqrt{(5-5)^2+(5-5)^2}=0$。所以距離愈少的,暗示了兩者相似度十分的高。 當明白了距離的藝術之後,要理解Clustering這算法的設...

機器學習之陷阱 - Imbalance Class Classification

Image
幾年前的筆者,一直覺得Build Model是一件很不可思議的事,一提到建模這個課題,就會眼前一亮,充滿好奇和期待,不知道讀者們有沒有嘗試過在做分類(Classification)的時候,一看到數據,也沒有想太多,直接就把數據倒進模型作訓練,再看看Performance有多少,看到準確度有92%,表現很不錯吧,我看的是不一定了,為了讓讀者們更好理解文中的意思,我會採用"十個男人九個滾"的例子來闡釋。 假設我收集了100個男人的資料,9成2的人都曾經對伴侶不忠,其餘的就管它是還在考慮或是打死不會,目的是從這些會出軌和不會的男人身上,讓我的Model學習出軌的男人特點,從而預測其他男人會否對伴侶不忠,剛才說過我的模型有92%的準成度,筆者還以為可以慶功食牛雜,女人們以為可以試試伴侶是否不忠的時候,才發現所有的男人都被預測為"出軌",當中包括真的會出軌的92人, 其餘8個白白被"砌了生豬肉",還未出去滾已慘遭被判為出軌,要是這樣,倒不如直接說成"十個男人十個滾",連Build Model的氣力也省去了,所以零分重作吧! Actual / Predict           滾             沒滾 / 唸緊   滾 92 0 沒滾 / 唸緊 8 0 但是為何會發生這種事呢?明明準確度很高,結果卻不似預期。其實原因很簡單,這都是數據的類別分佈出現不均勻和分類器(Classifier)的設計所造成的,因為一般的Classifier的學習目標是優化準成度,透過獲得愈少的誤差,才不會考慮類別的分佈,也就是少數的聲音很容易被埋沒,導致Classifier難以從少數類別的Pattern中學習,最壞的結果就是剛才的結果:所有數據都分成同一類別。 雖然Imbalance Class不是一個新鮮的問題,但對於入門級的人,想要對模型或數據分析技巧更上一層樓的話,這些基礎是少不了,如果沒有這些理論在背後支持,我相信街上每一個的Programmer也會比你強,只要寫幾句Coding,便能輕鬆實現建模,測試和預測,那麼你就好好想一下作為數據分析師的價值何在。...

Decision Tree - 充滿規則的算法

Image
Decision Tree(決策樹)故名思義,用樹的圖樣去表達數個規則,根據那些規則來決定那些的結果,很多時候我們會把自己所考慮的因素決定,在腦裡建立一個決策的樹,當筆者在決定買一樣東西時,就例如近期很紅的Switch,會先考慮一下,自己是否真的需要和價錢這兩個決定性的誘因,那我就把自己的想法以決策樹表達出來之後,最後的決定還是先別進坑。 你可能會問這跟Machine Learning或者Data Mining有何關係,關係就大了,在這些課題上,會研究如何讓這棵決策樹由最開始的根(root node),和自我生長成樹(tree node)和葉(Left node)。只要換上一幅較為有系統和正經的決策樹,就能知道這棵樹的結構,第一層的決定性的是對該貨品的需要性,如果真的需要的話,都不用考慮價錢了,所以到了第一層便停了。若果是不需要的活,倒是會看看價錢,便宜的話用作送禮也是不錯的選擇,貴的當然就不買了。其實這決策樹是由我的平日消費習慣而建立出來,也即是從每一次的消費行為中發掘這個決䇿模式,來決定會否大出血。 來到機器學習,Decision Tree亦一樣藉由學習已知的一組數據來學習和生長,其學習原理是把每一個特質(attribute)用作分成兩組數據,看看那一個特質會造成最大的Information Gain,從而決定利用該特質去作為分枝,也即是規則。這聽起來很抽象,回到剛才的例子,假設筆者有二十項購物紀錄,其中有12項是買了,8項的則是沒有買下來,所以在沒有任何機器或者資訊幫助之下,隨機地估計筆者會否買一件產品($P(buy)$),概率為$12/20 = 0.6$,反之,沒有買的則是$8/20 = 1 - 0.6 = 0.4$。大家可以想像到只有約一半的機會能猜中,所以我們要想辦法的提高這個機率,才能準確地預測。原來筆者凡是一共8件是需要的,其中7件會買,1件會放棄;而12件不需要的,其中5件被買下,7件放棄。來到這裡,已知筆者需要某產品,買下的機會, $P(buy | needed)$會變成$7/8$;已知筆者不需要某產品,買下的機會, $P(buy | not.needed)$則是$5/12$。我們可以觀察到凡是有需要的物品,筆者很大機會就會把大買下來,因些借由"需要"這個因素(特質),我們便能得到十分高...

邏輯迴歸 - 讓你知道"是"或"否"

Image
另一種稱為邏輯回歸 (Logistic Regression)的回歸模型用於描述某類別 (Categorical Variable)與獨立變量 (Independent Variables)之間的關係,並估計出現某類別的概率。 邏輯回歸中的輸出變量是分類而不是間隔。 可能讀者們早已聽過機器學習的Classification,它是Data Mining和Pattern Recognition中常見的應用之一。透過Logit Function的轉換,目標變量的類型變成了Categorical,不再是Numeric。 為了讓初學者容易理解邏輯回歸的精要,在本文中,會利用只有兩個類別的目標變數會作為例子(兩個類別為“是”或“否”)。 公式: $$ln(\frac{p}{1-p}) = w_0 + w_1x_1 + w_2x_2+...+w_nx_n=\sum_{i=1}^{m}{w_ix_i}=w^Tx$$ 當中的$p$為得到“是”的機率,透過一些轉換,我們會獲得新的公式(如下)。假設我們已經知道所有自變量, $x$和每個自變量的比重$w$,我們便能計算出得到“是”的機率。至於“否”的機率,明顯地是$1 - p$ $$p=\frac{1}{1+e^{-w^Tx}}$$ 邏輯回歸的Cost function的公式定義在下面,這其實由統計學上的Maximum Likelihood Estimation衍生出來,同樣地,目的是把Cost function的減至最少,從而獲得相應的比重, $w_i$。 $$J(w) = -\frac{1}{m}[\sum_{j=1}^{m}{(y^{(j)}log(h_w(x^{(j)}) + (1-y^{(j)})(log(h_w(x^{(j)}))}]$$ 從機器學習的角度出發,邏輯回歸運算的要求較低,易於實現和解釋。 然而,面對一些非線性關係的自變量,違反了模型本身的假設,其表現亦會減弱,即是更容易錯誤地分類。 在Python實現 1. 安裝Scikit-Learn 參考 先前的文章 安裝用作機器學習的Package。 2. 數集 數據 及可視化 假設我們有一組客戶的數據,包括他們的個人資料,消費量和今年有沒有續會( 按這裡下載 )。 我們的目標是根據這些歷史數據 (Training Data)預測一些新加...

線性迴歸 - 統計和預測的最基礎

Image
線性回歸 (Linear Regression) 應用於不同的方面以達到不同的目的。 描述自變量Independent Variables($ x_i $)和因變量Dependent Variables($ y $)之間的關係的方法,或者通過輸入($ x_i $)預測目標變量($ y $)。 還有助於我們了解在更改一個或多個獨立變量時對因變量變化的影響。 公式: $$y = w_0+w_1x_1+w_2x_2+ ... +w_nx_n$$ 也可以表示為: $$h_w(x)=\sum_{i=1}^{m}{w_ix_i}=w^Tx$$ Cost Function定義為$h_w(x^{(j)})$和$y^{(j)}$之間的差的平方和。 統計學上,被稱為平方誤差(Sum of Square Error, SSE)。 為了使直線符合$n$數據點,Cost Function / SSE需要最小化以實現優化目標,這過程又稱OLS Estimation(Ordinary least squares Estimation)。 直觀地想,預測值(Predicted value)和實際目標(Actual value)值之間的差異越小,預測模型給出的結果越接近實際值,也暗示這個模型的愈準確,誤差值亦愈小,$R^2$表示線性回歸模型解釋數據的能力。愈高的$R^2$意味著模型愈有能力解釋現有的數據。 它還量度總變異, $SST$和回歸平方誤差的和, $SSR$的比例。 $R^2=\frac{SSR}{SST}$, where $0\leq R^2\leq 1$ 但是,線性回歸面對著非線性關係的變數,不如其他模型那樣精確,如神經網絡,始終它假設輸入和輸出的線性關係。 線性回歸的另一個問題是它對Outlier(主要是Influence Point) 的敏感性,會影響預測結果的準確性。 在我們訓練模型之前,可以在某些圖表中或者統計結果中被識別,把Outlier踢出來解決這個問題。 In previous chapter , I have introduced the overall process of data mining. Some of you might not understand well. It should be fine since the s...

資料探索 - 數據挖掘過程的概述

Image
在之前的文章也提到過,資料探勘是從數據庫中找尋有用資料,或從未經結構化的數據中擷取有用信息的過程。資料 探索 模型在用法上不會只局限於Machine Learning演算法的應用。 到底這個方法如何運作呢?看看下圖來了解當中的過程吧: 數據整合 來自不同數據庫的資料會首先被整合,并存放於稱為數據倉庫的資料存放系統裡。其目的是準備原始數據並進一步處理。表格存放資料的格式都是由資料的特質(直行)和紀錄(橫行)組成。 抽樣 大部分的資料 探索 模型涉及複雜的演算法,當遇上太大量的數據,便難以進行分析。因此,只抽出部分的數據作建模以節省運算時間。 抽樣有幾種方法:例如隨機抽樣,系統抽樣和分群法(Clustering)。均是減少數據量的好方法。 數據探索 為了觀察數據的結構和檢測是否存在缺失和奇怪數據,所以先進行數據探索,可以利用統計的技巧來分析,概括和描述這些資料。而最常用的方法便是平均值和方差。毫無疑問,利用圖像代替數字來表達數據,不但能令讀者更容易洞察數據的分佈, 也更有助於把結果包裝成故事說給聽眾們。 數據清理 在現實中,並沒有“完美"的數據。 收集回來的數據不能避免有缺失或異常值(Outlier),所以我們需要進行數據的清理。 它的目的在於確保數據質量,從而提升數據挖掘的準確度。 先前寫下的文章 會為大家介紹一連串提升數據質量的方法。 數據分區 在挖掘資訊的過程,為了利用一部分的數據來驗證模型的準確性或者檢測模型有沒有過度學習。由於驗證模型並不是必要的,所以決定數據區需要分區也取向於分析的目的,也不是必要的步驟。一般來說,我們可以把數據源按一定比例分為三部分: 訓練,驗證,測試數據集。 首先利用訓練部分的數據中的目標變數(Target variable)來訓練及構建所需的模型。 而驗證部分的數據會被注入訓練數據的模型中,從中得出模型的表現(例如分類/預測的準確性),繼而選擇最佳模型。最後,測試數據會放入那個最佳的模型,獲得和評估得出的的結果。 建模 談到模型這部分,這無疑是萬眾期待和令人著迷的部分,因為不同的模型都有它們的作用,有些能用作分類,預測和分群法等。能夠用作分類的模型也可以分為監督式學習,有邏輯回歸,人工神娙網絡,K-近鄰和支持向量機模型,而非監督式學習則有分群法,自組織映射圖等。至於線性回歸,決...

數據淨化 - 提高你的數據質量

Image
很多時候,由於系統故障或人為輸入錯誤,產生一些不準確或錯誤的數據。事實上,這類意外的錯誤通常發生在我們的數據庫中,並在整個記錄中佔領一定的比例。 正所謂“高質量的數據能衍生高質的分析結果”,尤其是當我們製作統計報告的時候,任何缺失或重複的記錄也會誤導統計結果。例如,我們可能從交易資料庫中發現找到一些交易為零的記錄。 以機器學習(Machine Learning)的預測模型為例,由於一些極端的數會影響模型的預測表現,所以我們會刪除這些數值,避免影響該模型的性能。 我在唸大學期間,往往忽略了數據淨化的重要性。原因似乎是我看重了研究數據分析的方法而忽略數據的處理。直到我工作以後,才領略到先準備和處理數據的重要性。但在真實的工作環境中,要知道我們是不可能擁有具備完美的原始數據。在資料庫中提取了數據後,你仍然會發現在記錄中會存在一些意想不到的和不合理的數值。為了做統計分析和數據挖掘,並獲取可信賴的結果,我們必須清理和處理這些錯誤的數據。 但是,要怎樣評估數據或信息是否已經足夠好以作分析?數據的屬性可以用該行業知識和經驗去判斷和驗證。儘管一些該行業的專業人士沒有任何統計知識,他們依然有能力去判斷數值的真偽。所以有一些文章指出,擁有相應的行業和業務知識的數據科學家本身也是一項優勢。 數據的質量 以下是判斷數據質量的指標: 1.準確度 準確的數據可以反映在實際環境中的對象或事件。在錯誤的資料中,我們怎麼會獲取準確的結果呢?不準確的數據往往帶來不恰當的和誤導性的信息。 2.有效性 資料可以由各種各樣的方式來驗證,包括利用其類別,格式,邏輯或者總數等。例如,在某物件的數量發現有非整數值,此記錄可被視為無效。 3.一致性 來自不同來源的數據經過整合後,數據應與數據源一致。假設你既是高中或大學畢業生,又是某家商店的會員,但會員證仍然顯示“學生”,這就是不一致的數據。 4.冗餘性 愈有質量的數據含有愈少量的冗餘記錄,在一項記錄中,具獨一無二特性的數值是不能重複的,因為這會導致偏差也影響到結果的準確性。如果一張發票中存在兩個相同的交易記錄,您的客戶當然會埋怨,及有權拒絕支付雙倍費用。當你分析銷售記錄時,交易總額亦會因此而出錯。 5.完整性 完整的數據,內容應該符合使用者的期望。在網上登記表格中總會有一些必填項目,以確保接收者(...